01
Producten zijn moeilijk te vergelijken
Hetzelfde product kan bij verschillende leveranciers een andere naam, artikelcode of omschrijving hebben. Daardoor wordt automatisch vergelijken vrijwel onmogelijk.
Koppel bedrijven, producten en locaties automatisch. Verbeter datakwaliteit met intelligente data matching en betrouwbare datasetkoppelingen.
Veel organisaties beschikken over meerdere datasets die in de basis over hetzelfde onderwerp gaan.
Denk aan productbestanden van verschillende leveranciers.
Klantgegevens uit meerdere systemen.
Of marktdata uit uiteenlopende openbare bronnen.
In de praktijk blijken deze gegevens echter vaak net verschillend genoeg om niet automatisch aan elkaar gekoppeld te kunnen worden.
Een product heeft verschillende artikelnummers.
Een bedrijfsnaam wordt anders geschreven.
Een adres is niet volledig.
Of dezelfde organisatie komt meerdere keren voor.
Daardoor ontstaat versnipperde informatie en wordt vergelijken, analyseren en automatiseren lastig.
Scrape IT helpt organisaties om datasets automatisch te koppelen, te valideren en te verrijken met behulp van data matching.
Zo ontstaat één betrouwbaar informatiebeeld waarop analyses, dashboards en bedrijfsprocessen kunnen vertrouwen.
Organisaties verzamelen steeds meer data.
Maar data uit verschillende bronnen sluit zelden één-op-één op elkaar aan.
Denk bijvoorbeeld aan:
Zonder data matching blijven deze datasets losse informatiebronnen.
Door gegevens automatisch te koppelen ontstaat één consistente dataset waarmee organisaties betrouwbaarder kunnen analyseren en automatiseren.
De kwaliteit van analyses wordt niet bepaald door de hoeveelheid data. De kwaliteit wordt bepaald door de mate waarin gegevens correct aan elkaar zijn gekoppeld. Pas wanneer datasets dezelfde bedrijven, producten of locaties herkennen, ontstaat betrouwbare informatie.
Hetzelfde product kan bij verschillende leveranciers een andere naam, artikelcode of omschrijving hebben. Daardoor wordt automatisch vergelijken vrijwel onmogelijk.
Organisaties worden vaak op verschillende manieren geregistreerd. Afkortingen, typefouten of afwijkende schrijfwijzen zorgen ervoor dat dezelfde organisatie meerdere keren voorkomt.
Data afkomstig uit verschillende systemen gebruikt vaak andere structuren, veldnamen of identificaties. Hierdoor kunnen gegevens niet zonder extra bewerking worden gecombineerd.
Veel organisaties controleren datasets handmatig voordat analyses kunnen worden uitgevoerd. Naarmate datasets groeien wordt dit steeds tijdrovender en foutgevoeliger.
Goede data matching bestaat uit meer dan het vergelijken van twee spreadsheets.
De uitdaging is om verschillende databronnen automatisch te herkennen, te koppelen en te verrijken, zodat één consistente dataset ontstaat.
Scrape IT combineert slimme matchingtechnieken met validatie en dataverrijking om bedrijven, producten, locaties en andere entiteiten betrouwbaar aan elkaar te koppelen.
De oplossing wordt onder andere toegepast voor:
Productinformatie uit verschillende leveranciers of databronnen wordt automatisch gekoppeld. Hierdoor kunnen organisaties producten objectief vergelijken, ongeacht verschillen in productnamen, artikelcodes of omschrijvingen. Toepassingen zijn onder andere:
Bedrijven worden automatisch herkend, ook wanneer namen of gegevens niet exact overeenkomen. Hierdoor ontstaat één compleet bedrijfsbeeld over meerdere databronnen.
Locaties uit verschillende databronnen worden automatisch aan elkaar gekoppeld. Bijvoorbeeld vestigingen, verkooppunten, laadlocaties of vastgoedobjecten.
Dubbele records worden automatisch herkend en samengevoegd. Hierdoor neemt de datakwaliteit toe en beschikken organisaties over één consistente informatiebron.
Koppel automatisch bedrijven, producten en locaties uit verschillende databronnen en werk altijd met één betrouwbare dataset.
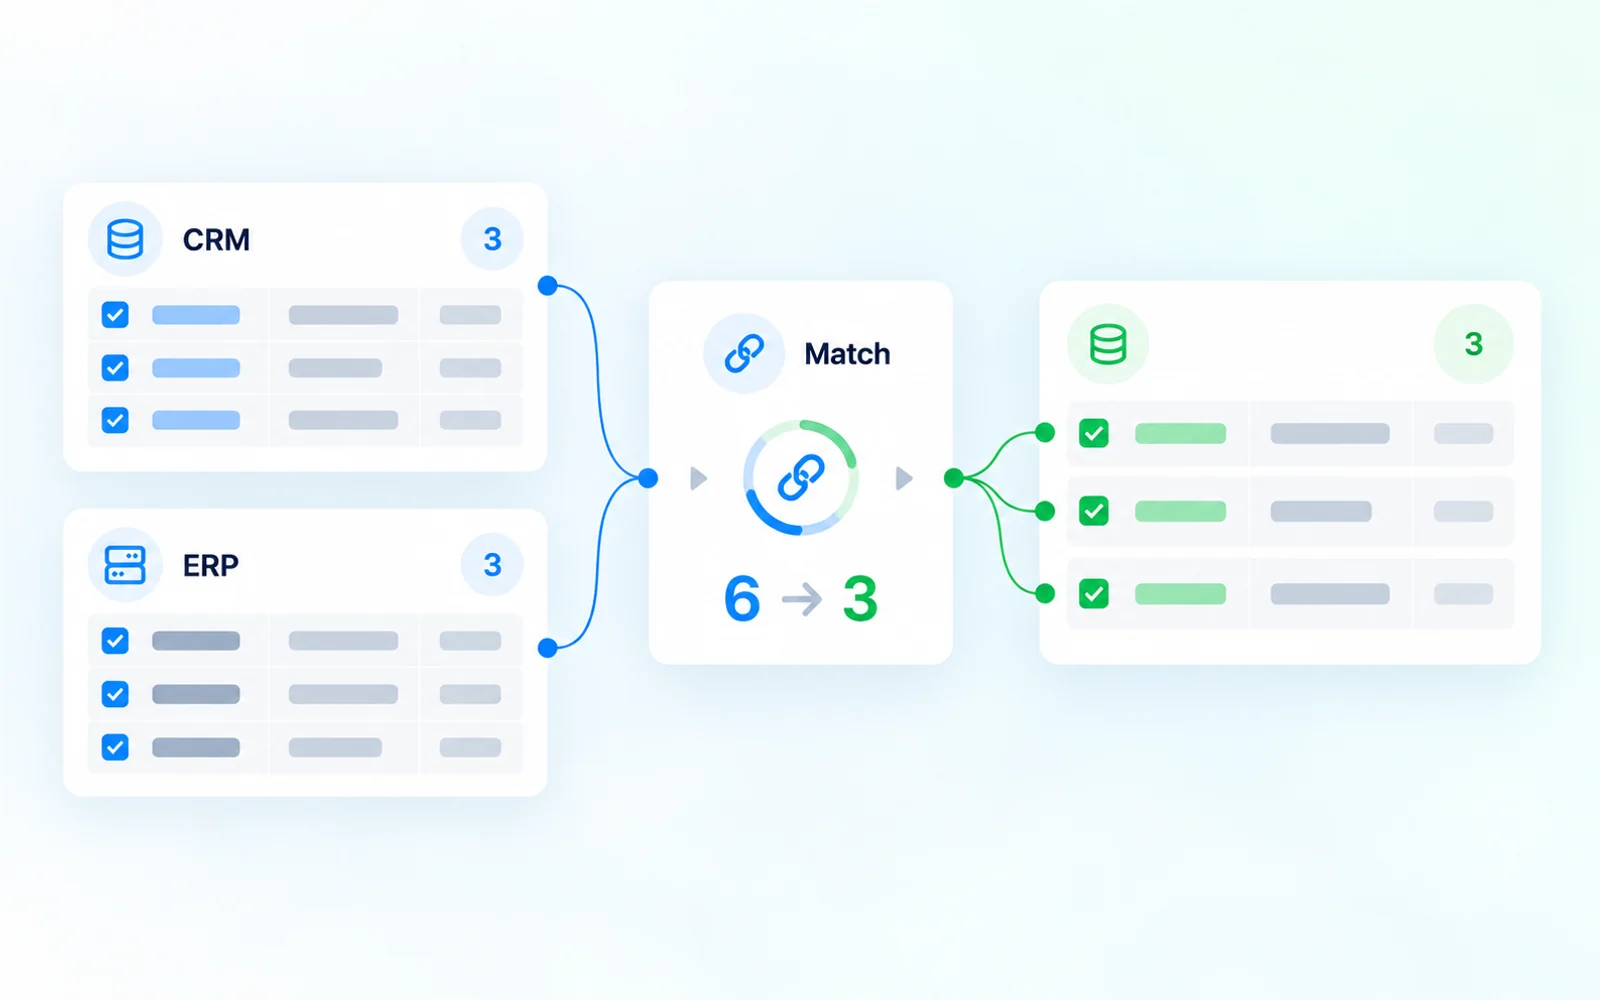
Veel organisaties werken dagelijks met gegevens uit verschillende bronnen.
Een deel komt uit het CRM.
Een ander deel uit een ERP-systeem.
Daarnaast worden externe datasets gebruikt of informatie verzameld uit openbare bronnen.
Op papier gaan deze datasets over dezelfde bedrijven, producten of locaties.
In de praktijk blijken de gegevens echter net verschillend genoeg om niet automatisch aan elkaar gekoppeld te kunnen worden.
Met data matching verandert deze werkwijze.
In plaats van:
Welke dataset is de juiste?
ontstaat inzicht in:
Hoe combineren we alle beschikbare informatie tot één betrouwbaar gegevensbestand?
Daardoor beschikken medewerkers altijd over één consistente dataset waarop analyses, dashboards en bedrijfsprocessen kunnen vertrouwen.
Door datasets automatisch te koppelen ontstaat een completer en betrouwbaarder informatiebeeld.
Veelgebruikte toepassingen zijn:
Organisaties realiseren hierdoor onder andere:
Vergelijk producten van verschillende leveranciers of concurrenten op basis van betrouwbare productmatching.
Voorkom dubbele klantrecords en werk met één compleet klantbeeld.
Koppel leveranciersdata uit verschillende systemen tot één betrouwbare dataset.
Werk met consistente datasets voor rapportages, analyses en datamodellen.
Verbeter de kwaliteit van bedrijfsdata en zorg voor één centrale bron van waarheid.
Organisaties beschikken vaak al over alle informatie die nodig is om betere beslissingen te nemen.
De uitdaging is dat deze informatie verspreid staat over verschillende systemen en databronnen.
Door bedrijven, producten, locaties en andere entiteiten automatisch aan elkaar te koppelen ontstaat één betrouwbaar informatiebeeld waarop analyses, dashboards en bedrijfsprocessen kunnen vertrouwen.
Daarmee wordt data matching meer dan een technische stap binnen een dataproces.
Het vormt de basis voor data intelligence, waarbij organisaties werken met consistente, complete en betrouwbare gegevens die direct inzetbaar zijn voor analyses, automatisering en besluitvorming.
Data matching is het automatisch herkennen en koppelen van dezelfde bedrijven, producten, locaties of andere entiteiten uit verschillende databronnen. Hierdoor ontstaat één consistente dataset waarmee organisaties betrouwbaarder kunnen analyseren en automatiseren.
Gegevens uit verschillende systemen sluiten vaak niet één-op-één op elkaar aan. Door datasets automatisch te koppelen ontstaat een completer informatiebeeld, neemt de datakwaliteit toe en worden analyses betrouwbaarder.
Afhankelijk van uw toepassing kunnen onder andere de volgende gegevens worden gekoppeld: producten; bedrijven; klanten; leveranciers; locaties; adressen; objecten; andere unieke entiteiten.;
Bij data matching worden verschillende kenmerken met elkaar vergeleken, zoals namen, productcodes, adressen of andere identificerende gegevens. Op basis daarvan worden records automatisch gekoppeld tot één consistente dataset.
Nee. Data matching is waardevol voor zowel kleine als grote datasets. Naarmate het aantal databronnen groeit, neemt de meerwaarde van automatische matching doorgaans verder toe.
Ja. Veel organisaties combineren interne gegevens met openbare databronnen of marktinformatie om een completer en betrouwbaarder informatiebeeld op te bouwen.
Deze oplossing wordt onder andere gebruikt door: retailorganisaties; groothandels; productiebedrijven; e-commercebedrijven; financiële dienstverleners; organisaties met meerdere databronnen.;
De gematchte data kan worden geleverd in vrijwel ieder gewenst formaat of rechtstreeks worden geïntegreerd met bestaande systemen. Denk onder andere aan: API; dashboards; CSV, Excel, JSON, XML of Parquet; Power BI; MCP voor directe integratie met AI-toepassingen; EDI; (S)FTP; e-mailalerts; rechtstreekse integratie met eigen systemen.; Kortom: vrijwel iedere gewenste vorm van datalevering of integratie is mogelijk.
Ja. Veel organisaties combineren data matching met MCP AI data integratie voor AI-toepassingen, dashboarding voor realtime analyses en intelligence-oplossingen zoals prijsmonitoring en marktinformatie & concurrentieanalyse.
Data matching richt zich op het herkennen en koppelen van gegevens uit verschillende databronnen, zodat één consistente dataset ontstaat. CRM-verrijking richt zich op het aanvullen en actualiseren van klant- en prospectgegevens binnen een CRM-systeem. Veel organisaties combineren beide oplossingen om zowel de datakwaliteit als de volledigheid van hun CRM te verbeteren.
Bespreek welke interne en externe databronnen u wilt verbinden en hoe actuele informatie beschikbaar moet worden voor dashboards, AI en bedrijfsprocessen.